Datum: 24.09.2026
Kako izabrati AI model: GLM 5.2, Kimi K2.7 i DeepSeek V4 Flash u poređenju
Poređenje GLM 5.2, Kimi K2.7 i DeepSeek V4 Flash po tipu zadatka, dužini konteksta i ceni po poslu. Plus zašto morate sami da testirate na srpskom.
Blog
28.09.2026.
DRaaS (Disaster Recovery as a Service) je usluga kod koje provajder u svom data centru održava replicirano i unapred pripremljeno okruženje vaših najvažnijih sistema. Kada primarna infrastruktura otkaže, sistemi se pokreću u tom rezervnom okruženju.
Za razliku od backupa, čija je osnovna uloga vraćanje podataka, DRaaS vraća kompletne sisteme u funkcionalno stanje. Oporavak zato obično traje nekoliko minuta ili sati, umesto nekoliko dana.
Većina kompanija koje razmatraju ovu uslugu već ima backup i pretpostavlja da je time dovoljno zaštićena. Podaci pokazuju drugačiju sliku. Prema izveštaju Veeam Data Trust and Resilience 2026, 90 odsto organizacija veruje da može uspešno da se oporavi od sajber incidenta. Međutim, samo 28 odsto njih nakon napada je zaista vratilo sve pogođene podatke, dok je prosečan stepen oporavka iznosio 72 odsto.
DRaaS rešenje postoji upravo zbog razlike između očekivanog i stvarno ostvarenog oporavka.
Cilj ovog teksta nije da preporuči failover svakoj kompaniji. Umesto toga, daje konkretne pokazatelje pomoću kojih možete samostalno da procenite da li vam je ovakva usluga potrebna.
Zamislite da otkaže virtuelizacioni host na kojem radi ERP sistem. Ako imate samo backup, postupak oporavka izgleda ovako: prvo treba popraviti ili nabaviti hardver, zatim instalirati hipervizor, vratiti virtuelne mašine, proveriti integritet baze podataka i tek nakon toga omogućiti korisnicima da nastave sa radom.
U praksi ovaj proces traje od jednog do nekoliko radnih dana. Nabavka odgovarajućeg hardvera često je najsporiji korak.
Kod DRaaS-a replike istih virtuelnih mašina već postoje u data centru provajdera. Umesto ponovne izgradnje čitavog okruženja, saobraćaj se preusmerava na unapred pripremljene sisteme.
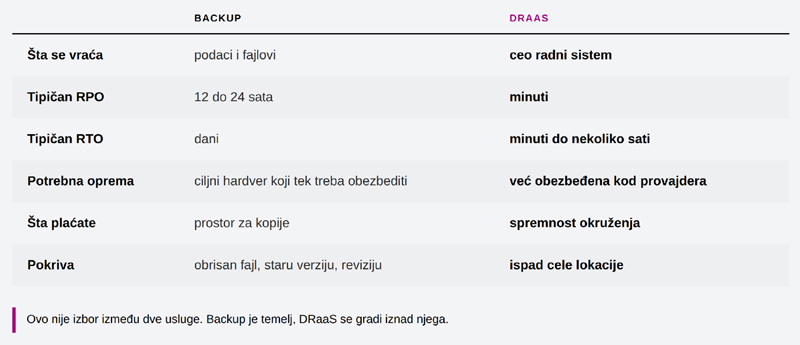
Ovo nije izbor između dve međusobno isključive usluge. Backup as a Service ostaje osnovni sloj zaštite i rešava situacije koje DRaaS ne pokriva, poput vraćanja fajla obrisanog pre tri meseca ili pronalaženja starih podataka potrebnih revizoru.
DRaaS se nadograđuje na backup i namenjen je scenariju u kojem cela lokacija ili kompletna infrastruktura prestane da radi.
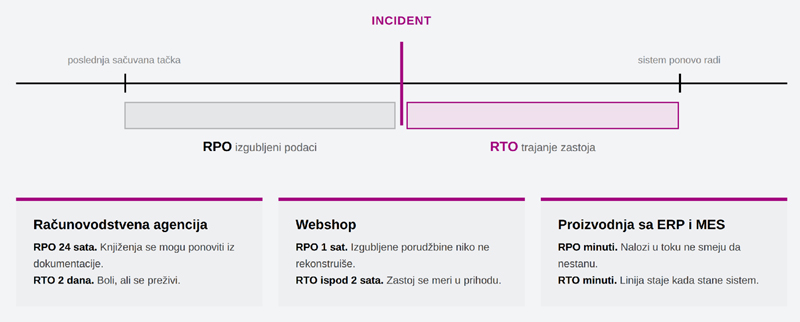
RPO (Recovery Point Objective) predstavlja količinu podataka koju kompanija može da izgubi, izraženu kroz vreme. RPO od 24 sata znači da ćete nakon incidenta nastaviti rad sa stanjem baze iz prethodnog dana.
RTO (Recovery Time Objective) predstavlja najduže vreme za koje sistem mora ponovo da postane dostupan.
Obe vrednosti predstavljaju poslovne odluke, a ne samo tehničke parametre. Treba da ih odredi uprava kompanije, a ne isključivo sistem administrator.
Nekoliko primera pokazuje kako RTO i RPO izgledaju u praksi.
Kada jasno definišete ove dve vrednosti, odgovarajuća tehnologija postaje mnogo lakša za izbor. RTO od tri dana verovatno ne zahteva DRaaS. RTO od trideset minuta gotovo sigurno zahteva.
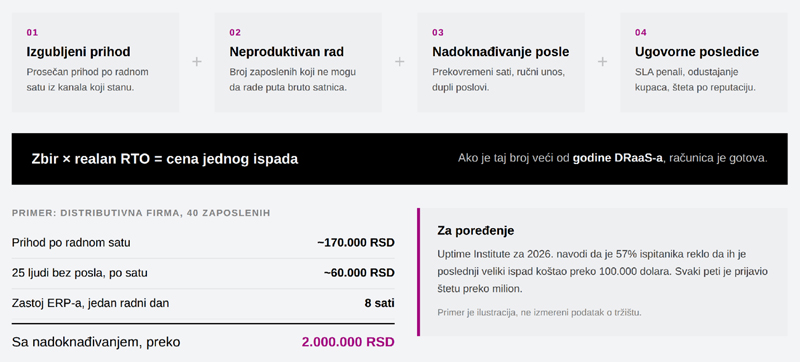
Ovo pitanje često izostaje iz razgovora o oporavku poslovnih sistema. Trošak jednog sata zastoja sastoji se od četiri stavke.
Zbir sve četiri stavke treba pomnožiti sa RTO vrednošću koju vaša infrastruktura danas realno može da pruži. Nemojte računati sa vremenom oporavka koje biste želeli, već sa onim koje zaista možete da ostvarite.
Rezultat često iznenadi rukovodstvo. Uptime Institute u analizi ispada iz 2026. godine navodi da je 57 odsto ispitanika poslednji veliki prekid koštao više od 100.000 dolara. Svaki peti ispitanik prijavio je štetu veću od milion dolara.
Kao primer možemo uzeti distributivnu kompaniju sa 40 zaposlenih i mesečnim fakturisanim prihodom od 30 miliona dinara. Jedan radni sat donosi joj približno 170.000 dinara prihoda.
Kada ERP prestane da radi, zaustavljaju se prijem robe, izdavanje i fakturisanje. Ako 25 zaposlenih za to vreme prima platu, a ne može da radi, kompanija gubi još oko 60.000 dinara po satu. Kada se dodaju naknadni ručni unos i poslovi potrebni nakon vraćanja sistema, trošak jednog radnog dana zastoja lako prelazi dva miliona dinara.
Taj iznos treba uporediti sa godišnjom cenom održavanja replike u data centru provajdera.
Taj iznos treba uporediti sa godišnjom cenom održavanja replike u data centru provajdera.
Prag odluke je jednostavan: ako jedan dan prekida poslovanja košta više od cele godine korišćenja DRaaS-a, računica je završena i
Jedna serverska sala, jedan UPS i jedan dovod električne energije predstavljaju jednu tačku rizika. Redundantni diskovi ne pomažu kada čitava prostorija postane nedostupna.
Webshop, sistem za naplatu, dispečerski centar i proizvodna linija samo su neki od primera. Ako se zastoj sistema neposredno pretvara u finansijski gubitak, DRaaS se ne kupuje iz straha, već na osnovu jasne računice.
Ako se backup server nalazi u istom domenu i na istoj mreži kao produkcija, bez immutable kopije i bez fizički ili logički odvojene lokacije, napadač ga može šifrovati zajedno sa glavnim sistemima.
Replika smeštena u drugom data centru, sa zasebnim pristupnim podacima, može potpuno da promeni ishod napada.
Proveru možete obaviti za pet minuta: utvrdite ko iz vaše mreže ima pravo da obriše sadržaj backup repozitorijuma. Ako to pravo ima domenski administrator, postoji problem koji se ne može rešiti kupovinom još jedne trake za backup.
Veliki klijenti, revizori i naručioci na tenderima sve češće zahtevaju dokumentovan plan oporavka i izveštaj o njegovom testiranju. Izjava „imamo backup” više nije dovoljan dokaz.
Postoje kompanije kojima ova usluga objektivno nije potrebna.
Ako poslovanje može dva ili tri dana da funkcioniše putem telefona, mejla i papirne dokumentacije bez merljive finansijske štete, DRaaS je verovatno preskupo rešenje za problem koji kompanija nema.
Isto važi kada su svi kritični sistemi već dostupni kao SaaS usluge kod provajdera koji garantuje njihovu raspoloživost, dok se lokalna infrastruktura koristi samo za čuvanje fajlova i štampanje.
U oba slučaja bolje je uložiti u kvalitetan backup koji ima immutable kopiju, čuva se na odvojenoj lokaciji i redovno se testira kroz postupak vraćanja.
Testiran restore je ključan. Backup čiji sadržaj nikada nije uspešno vraćen nije pouzdana zaštita, već samo pretpostavka da zaštita postoji.
Novi Zakon o informacionoj bezbednosti u članu 10 navodi mere zaštite koje operatori IKT sistema moraju da primenjuju.
Među njima su izričito navedene „zaštita od gubitka podataka redovnom izradom rezervnih kopija podataka, softvera i sistema” i „mere koje obezbeđuju kontinuitet obavljanja posla u vanrednim okolnostima koje se definišu Planom kontinuiteta obavljanja posla”.
Značajan incident mora se prijaviti nacionalnom CERT-u u roku od 24 sata.
Za kompanije koje potpadaju pod ovaj zakon plan kontinuiteta nije preporuka, već obaveza sa definisanim rokom. Ako tek počinjete njegovu izradu, RTO i RPO treba da budu među prvim vrednostima koje ćete utvrditi.
Pre poređenja ponuda proverite koji model usluge kupujete. Glavna razlika je u tome ko obavlja potrebne korake u trenutku incidenta.
Kompanije bez internog IT tima gotovo uvek treba da izaberu upravljani model. Nema mnogo smisla plaćati replikaciju ako će se tokom incidenta izgubiti pola dana zato što niko nije siguran koji korak treba sledeći da preduzme.
Nemojte početi od traženja ponude, već od definisanja dva broja.
Zajedno sa upravom utvrdite koliko dugo kompanija može da izdrži bez kritičnih sistema i koliko podataka sme da izgubi. Tek nakon toga proverite kakav oporavak postojeća infrastruktura zaista može da pruži.
Ako je razlika između potrebnog i stvarnog vremena velika, inženjeri Orion Telekoma mogu da analiziraju postojeće okruženje i predlože rešenje koje pokriva upravo taj jaz.
Backup je kopija podataka koja se vraća na odgovarajući sistem. Disaster recovery je celokupan proces kojim se serveri, mreža, aplikacije i podaci vraćaju u radno stanje.
Backup odgovara na pitanje „gde su podaci”, dok disaster recovery odgovara na pitanje „kada možemo ponovo da radimo”. Backup je preduslov za uspešan oporavak, ali sam po sebi ne obezbeđuje kratak zastoj.
RTO (Recovery Time Objective) je najduži period zastoja koji poslovanje može da podnese.
RPO (Recovery Point Objective) predstavlja najveću prihvatljivu količinu izgubljenih podataka, izraženu kao vreme proteklo od poslednje sačuvane tačke.
RTO od dva sata i RPO od petnaest minuta znače da sistem mora ponovo da proradi za najviše dva sata, sa podacima koji nisu stariji od petnaest minuta.
Cena zavisi od broja i veličine virtuelnih mašina koje treba replicirati, ugovorenih RTO i RPO vrednosti i izabranog načina naplate.
Kraći RTO zahteva više resursa u stalnoj pripravnosti, pa je takva usluga skuplja. Većina provajdera, uključujući Orion Telekom, naplaćuje prema iskorišćenim resursima, zbog čega cena prati stvarnu veličinu zaštićenog okruženja.
Cloud provajder garantuje dostupnost sopstvene platforme, ali ne nužno i oporavak vaših podataka, aplikacija i konfiguracije.
Slučajno brisanje, greška prilikom primene izmene, kompromitovan nalog i ransomware mogu pogoditi i cloud okruženje. Ako poslovanje zahteva kratak RTO, replika kod nezavisnog provajdera i dalje može imati smisla.
Blog
Poređenje GLM 5.2, Kimi K2.7 i DeepSeek V4 Flash po tipu zadatka, dužini konteksta i ceni po poslu. Plus zašto morate sami da testirate na srpskom.
Blog
Sedam kriterijuma za izbor softvera za e-fakture u Srbiji: integracija sa SEF-om, arhiva, e-otpremnice i stvarna cena. Uz pitanja za provajdera.
Blog
Koliko zaista košta VoIP za firmu u Srbiji: šest stavki računa, rasponi cena po broju lokala i zašto kanali, a ne lokali, određuju ponudu.