Datum: 18.09.2026
Softver za e-fakture: na šta obratiti pažnju pri izboru
Sedam kriterijuma za izbor softvera za e-fakture u Srbiji: integracija sa SEF-om, arhiva, e-otpremnice i stvarna cena. Uz pitanja za provajdera.
Blog
24.09.2026.
Izbor AI modela svodi se na tri ključna pitanja: koju vrstu zadatka treba da reši, koliko mu je konteksta potrebno i koliko košta jedan uspešno obavljen posao. Rezultati na benchmark testovima ne daju direktan odgovor ni na jedno od njih.
GLM 5.2, Kimi K2.7 i DeepSeek V4 Flash namenjeni su različitim profilima opterećenja. Pravi izbor zato zavisi od toga koji profil najviše odgovara načinu na koji će vaša kompanija koristiti model.
Većina poređenja ova tri modela dostupnih na internetu zasniva se na testovima kao što su SWE-bench, Terminal Bench i sličnim zadacima programiranja. Ako se vaša kompanija ne bavi razvojem softvera, takve tabele ne mere ono što vam je najvažnije.
Ovaj tekst polazi od konkretnog zadatka, a ne od ukupnog skora. Pretpostavlja se da već razumete kako inference funkcioniše i zbog čega se korišćenje modela naplaćuje prema broju tokena.
Sva tri modela koriste mixture-of-experts, odnosno MoE arhitekturu. Takav model može da ima veoma veliki ukupan broj parametara, ali za obradu svakog tokena aktivira samo njihov manji deo.
Zahvaljujući tome model sa 744 milijarde ukupnih parametara može da bude brži i povoljniji od gušćeg modela koji ima dvostruko manje parametara, ali ih koristi sve pri svakom koraku obrade.
| GLM 5.2 | Kimi K2.7 | DeepSeek V4 Flash | |
| Arhitektura | 744B MoE | ~1.000B MoE | 284B MoE |
| Aktivni parametri | ~40B | 32B | 13B |
| Kontekstni prozor | 1M tokena | 262K tokena | 1M tokena |
| Ulaz | tekst | tekst i slika | tekst |
| Licenca | MIT | otvoreni weights | otvoreni weights |
| Cena input (1M tokena) | $1,00 | $1,00 | $0,50 |
| Cena output (1M tokena) | $4,00 | $4,00 | $1,50 |
Za procenu brzine i troška važniji je broj aktivnih nego ukupan broj parametara. DeepSeek V4 Flash po tokenu aktivira 13 milijardi parametara, dok GLM 5.2 aktivira približno 40 milijardi. Ta razlika direktno se odražava na cenu obrade i vreme odziva.
Sva tri modela dostupna su putem istog REST API-ja u okviru pay-as-you-go inference usluge, uz jedan pristupni ključ i naplatu prema potrošenim tokenima.
To znači da izbor ne mora biti konačan. Jedna aplikacija može da šalje različite vrste zadataka različitim modelima.
Prema pregledu koji je objavio MarkTechPost, GLM 5.2 ostvaruje rezultat 62,1 na testu SWE-bench Pro i 82,7 na Terminal Bench 2.1. SWE-bench meri koliko uspešno model rešava stvarne prijave grešaka iz GitHub repozitorijuma.
Ako je vaš poslovni zadatak izdvajanje deset polja iz skenirane fakture, takav rezultat pruža samo posrednu informaciju.
Benchmark skorovi ipak mogu biti korisni kao pokazatelj gornje granice sposobnosti rezonovanja. Model koji uspešno rešava složene softverske i inženjerske zadatke verovatno neće imati problema sa jednostavnom klasifikacijom tiketa.
Obrnuto, međutim, ne mora da važi. Jeftiniji model sa slabijim rezultatom na SWE-bench testu može biti sasvim dovoljan za vaš konkretan zadatak, uz trošak koji je višestruko niži.
Postoji i praktično ograničenje. Javne tabele obično porede najnovije flagship verzije, dok se u produkciji najčešće koriste stabilna izdanja koja su već integrisana i proverena. Poređenje modela kojima ne možete neposredno da pristupite nema veliku praktičnu vrednost.
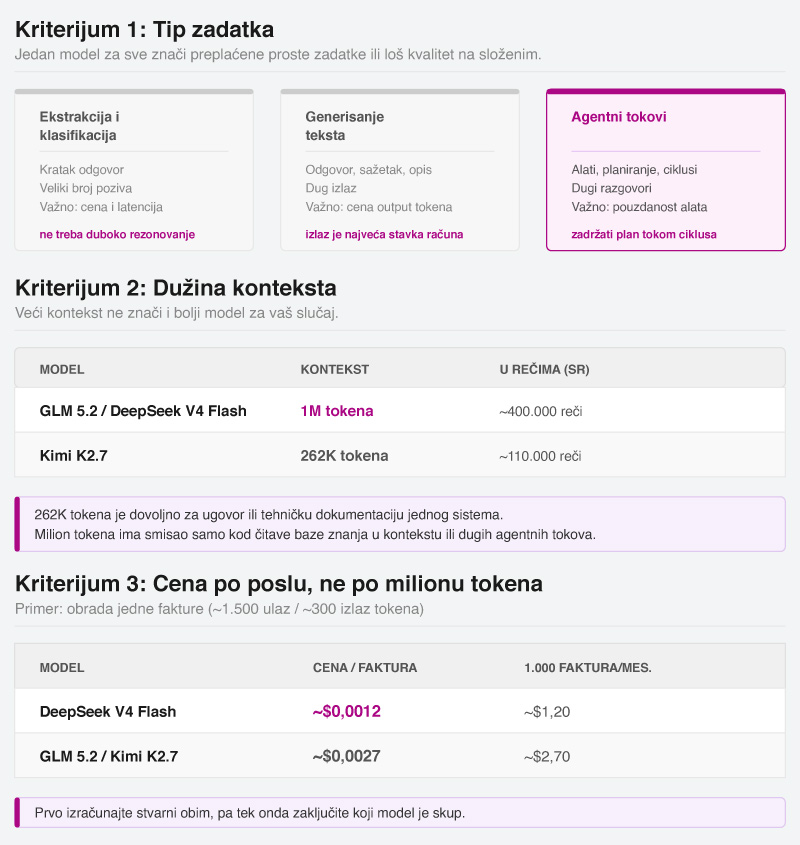
Poslovne zadatke podelite u tri grupe.
Ekstrakcija i klasifikacija. Model analizira ulaz i vraća strukturiran rezultat, poput kategorije, skupa izdvojenih polja ili ocene. Odgovori su kratki, a broj poziva veliki. Kod ovih zadataka najvažniji su cena i latencija, a ne maksimalna dubina rezonovanja.
Generisanje teksta. Model piše odgovor korisniku, sažetak, opis ili predlog. Pošto je izlaz često dug, cena output tokena postaje najveća stavka računa.
Agentni tokovi. Model poziva alate, obrađuje dobijene rezultate, planira naredni korak i ponavlja ciklus više puta. Za ovakve zadatke važni su pouzdano korišćenje alata, stabilnost tokom dugog razgovora i sposobnost modela da zadrži početni plan.
Ova podela nije samo teorijska. Većina kompanija koje uvode AI istovremeno ima sva tri tipa zadatka, ali ih često posmatra kao jedan.
Klasifikacija pristiglih mejlova i pisanje odgovora klijentu imaju potpuno različite zahteve, iako oba procesa na prvi pogled predstavljaju rad sa tekstom. Ako se za sve koristi jedan model, kompanija ili preplaćuje jednostavne zadatke ili gubi kvalitet na složenim.
GLM 5.2 i DeepSeek V4 Flash imaju kontekstni prozor od milion tokena. Kimi K2.7 podržava 262.144 tokena.
Na srpskom jeziku 262K tokena predstavlja približno 110.000 reči. To je dovoljno za obiman ugovorni predmet ili kompletnu tehničku dokumentaciju jednog sistema. Za većinu poslovnih zadataka takav kapacitet nije ograničenje.
Kontekst od milion tokena donosi stvarnu prednost u dva slučaja. Prvi je kada model treba da drži čitavu bazu znanja u kontekstu umesto da je pretražuje. Drugi je dugotrajan agentni zadatak kod kojeg se istorija koraka i razgovora povećava iznad nižeg ograničenja.
Ako vaš proces koristi manje od 100.000 tokena, veći kontekstni prozor ne donosi praktičnu korist.
Cena izražena kao $1,00 za milion tokena ne govori mnogo dok se ne pretvori u trošak jednog konkretnog zadatka.
Uzmimo kao primer obradu fakture. Dokument pretvoren u tekst ima približno 1.500 ulaznih tokena, dok strukturiran odgovor sa izdvojenim poljima sadrži oko 300 izlaznih tokena.
Na modelu DeepSeek V4 Flash obrada jedne fakture košta približno $0,0012. Obrada hiljadu faktura mesečno košta oko $1,20.
Na modelima GLM 5.2 ili Kimi K2.7 ista faktura košta približno $0,0027, odnosno oko $2,70 za hiljadu dokumenata.
Razlika je nešto veća od dvostruke, ali su apsolutni iznosi i dalje mali. Ako mesečno obrađujete hiljadu dokumenata, ušteda od približno dolar i po ne treba da bude presudna.
Ako obrađujete dva miliona zahteva mesečno, ista procentualna razlika pretvara se u hiljade dolara i postaje jedan od glavnih kriterijuma. Zbog toga prvo treba izračunati stvarni obim, pa tek onda zaključiti koji je model skup.
Kod zadataka koji generišu duži tekst odnos troškova se menja. Ako model priprema odgovor korisniku podrške, ulaz može biti kratak, dok odgovor može imati hiljadu tokena. Tada izlaz čini najveći deo računa, pa razlika između $1,50 i $4,00 za milion output tokena postaje mnogo važnija.
Isto pravilo važi za sažimanje dokumenata i pisanje opisa: što je odgovor duži, veća je korist od niže cene izlaznih tokena.
DeepSeek V4 Flash aktivira 13 milijardi parametara po tokenu, zbog čega je najbrži i najpovoljniji model u ovoj grupi.
Prema specifikaciji, podržava pozivanje alata i strukturirane izlaze, a namenjen je zadacima kod kojih su brzina odgovora i cena važnije od maksimalne dubine rezonovanja.
Dobar je izbor za klasifikaciju i usmeravanje tiketa korisničke podrške, izdvajanje podataka iz dokumenata, moderaciju sadržaja, pisanje opisa proizvoda u katalogu i druge procese koji se izvršavaju hiljadama puta dnevno.
Kontekstni prozor od milion tokena omogućava mu da radi i sa veoma velikim dokumentima.
GLM 5.2 ostvaruje najbolje rezultate u ovoj grupi na zadacima koji zahtevaju složeno rezonovanje. Među njima je i rezultat 91,2 na GPQA-Diamond testu naučnih pitanja.
Model je objavljen pod MIT licencom. To znači da ga možete samostalno hostovati bez dodatnih pravnih ograničenja ako se kasnije odlučite za prelazak na sopstvenu infrastrukturu.
Koristite ga za interne razvojne alate, generisanje i proveru koda, agentne tokove koji rade sa terminalom i drugim sistemima, analitičke zadatke nad podacima i sve situacije u kojima je cena potencijalne greške veća od cene tokena.
Zahvaljujući kontekstnom prozoru od milion tokena, pogodan je i za analizu obimnih dokumenata.
Kimi K2.7 je jedini od tri poređena modela koji, zahvaljujući ugrađenom vizuelnom enkoderu, može da prima slike kao ulaz.
Model uvek radi u režimu razmišljanja i, prema zvaničnoj dokumentaciji, koristi približno 30 odsto manje tokena za rezonovanje od prethodne verzije. Razvijen je za softverske i druge zadatke koji se izvršavaju kroz veliki broj koraka.
Izaberite ga kada obrađujete skenirane dokumente ili snimke ekrana, kada agent koristi alate tokom desetina uzastopnih koraka i kada je važno da zadrži plan kroz dug razgovor.
Kontekstni prozor od 262K tokena predstavlja jedino značajnije ograničenje, ali samo u procesima koji akumuliraju dugu istoriju bez povremenog sažimanja.
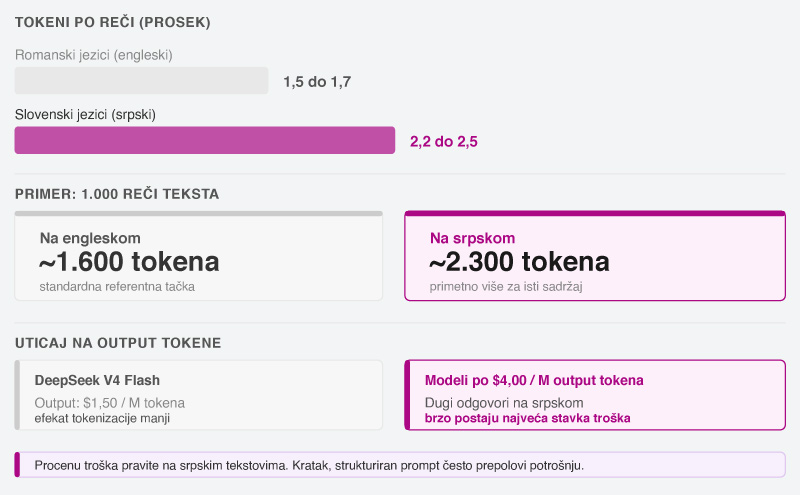
Tokenizatori nisu podjednako efikasni za sve jezike. Prema radu Tokenizer Tax, slovenski jezici prosečno koriste između 2,2 i 2,5 tokena po reči, dok romanski jezici koriste između 1,5 i 1,7.
Praktična posledica je da isti sadržaj napisan na srpskom troši primetno više tokena nego njegova verzija na engleskom. Tekst od hiljadu reči na srpskom zauzima približno 2.300 tokena.
Ova razlika posebno utiče na zadatke sa skupim izlaznim tokenima. Kod modela koji naplaćuju output po ceni od $4,00 za milion tokena, dugi odgovori na srpskom mogu brzo postati najveća stavka troška. Kod modela DeepSeek V4 Flash, čiji output košta $1,50, isti efekat je manji.
Zbog toga procenu troška pravite na srpskim tekstovima, a ne na engleskim primerima iz dokumentacije.
Istovremeno proverite da li su dugi odgovori zaista neophodni. Precizniji prompt koji zahteva kratak i strukturiran rezultat često može da prepolovi potrošnju bez vidljivog gubitka kvaliteta.
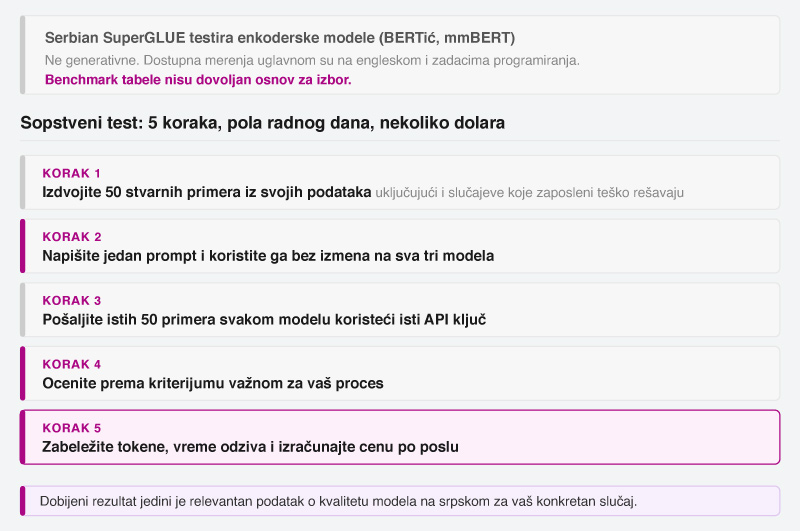
Za srpski jezik postoji ozbiljan evaluacioni okvir. Serbian SuperGLUE, predstavljen na konferenciji
LoResLM 2026, obuhvata sedam zadataka razumevanja jezika.
Međutim, ovaj okvir testira enkoderske modele kao što su BERTić i mmBERT, a ne generativne modele koji se porede u ovom tekstu.
Za GLM 5.2, Kimi K2.7 i DeepSeek V4 Flash ne postoje javno dostupni rezultati na srpskom jeziku. Dostupna merenja uglavnom su sprovedena na engleskom i pretežno se odnose na zadatke programiranja.
Zbog toga poslednji korak izbora ne može biti samo čitanje benchmark tabela. Potrebno je sprovesti sopstveni test, a to je jednostavnije i jeftinije nego što deluje:
Test sa 50 primera na sva tri modela košta nekoliko dolara i može se završiti za pola radnog dana. Dobijeni rezultat jedini je relevantan podatak o kvalitetu modela na srpskom jeziku za vaš konkretan slučaj.
Nemojte birati model samo na osnovu uporedne tabele. Najpre razvrstajte zadatke prema profilu, procenite mesečni obim, a zatim testirajte sva tri modela na sopstvenim podacima.
U praksi se često pokaže da je najbolja kombinacija dva modela: jedan obrađuje masovne i jednostavne zadatke, dok drugi preuzima ređe, složenije zahteve.
Orion AI Factory omogućava pristup svim trima modelima pomoću jednog API ključa, uz naplatu prema potrošnji i bez početnog ulaganja u infrastrukturu.
Aktivirajte ključ, obradite svojih 50 primera i prepustite odluku rezultatima.
DeepSeek V4 Flash je najpovoljniji. Cena iznosi $0,50 za milion input tokena i $1,50 za milion output tokena. GLM 5.2 i Kimi K2.7 koštaju $1,00 za input, odnosno $4,00 za output.
Kod zadataka sa kratkim odgovorima ukupan trošak korišćenja modela DeepSeek V4 Flash približno je dvostruko niži.
Da. Sva tri modela dostupna su putem istog REST API-ja i mogu se koristiti sa istim pristupnim ključem. Aplikacija zato može da usmerava zadatke prema njihovoj vrsti.
Uobičajen pristup je da povoljniji model obrađuje veliki broj jednostavnih zahteva, dok snažniji model preuzima zadatke koje prvi ne može dovoljno pouzdano da reši.
Za većinu poslovnih zadataka dovoljno je 262K tokena, što odgovara približno 110.000 reči srpskog teksta.
Kontekstni prozor od milion tokena ima smisla kada se čitava baza znanja drži u kontekstu ili kada agentni proces akumulira veoma dugu istoriju koraka i razgovora.
Sva tri modela mogu da rade sa srpskim jezikom, ali za njih ne postoje javno dostupni benchmark rezultati na srpskom.
Postojeći evaluacioni okviri za srpski obuhvataju druge tipove modela. Zbog toga je test na sopstvenim primerima jedini pouzdan način da uporedite kvalitet za svoj konkretan zadatak.
Mixture-of-experts model ne koristi sve svoje parametre prilikom obrade svakog tokena, već aktivira samo deo njih.
DeepSeek V4 Flash ima ukupno 284 milijarde parametara, ali za svaki token koristi 13 milijardi. Manji broj aktivnih parametara znači manje računanja po tokenu, što se obično odražava na nižu cenu i kraće vreme odziva.
Blog
Sedam kriterijuma za izbor softvera za e-fakture u Srbiji: integracija sa SEF-om, arhiva, e-otpremnice i stvarna cena. Uz pitanja za provajdera.
Blog
Koliko zaista košta VoIP za firmu u Srbiji: šest stavki računa, rasponi cena po broju lokala i zašto kanali, a ne lokali, određuju ponudu.
Blog
Bodovna tablica sa pet kriterijuma, prag odluke i redosled prva tri procesa za automatizaciju AI agentima u prvih 90 dana